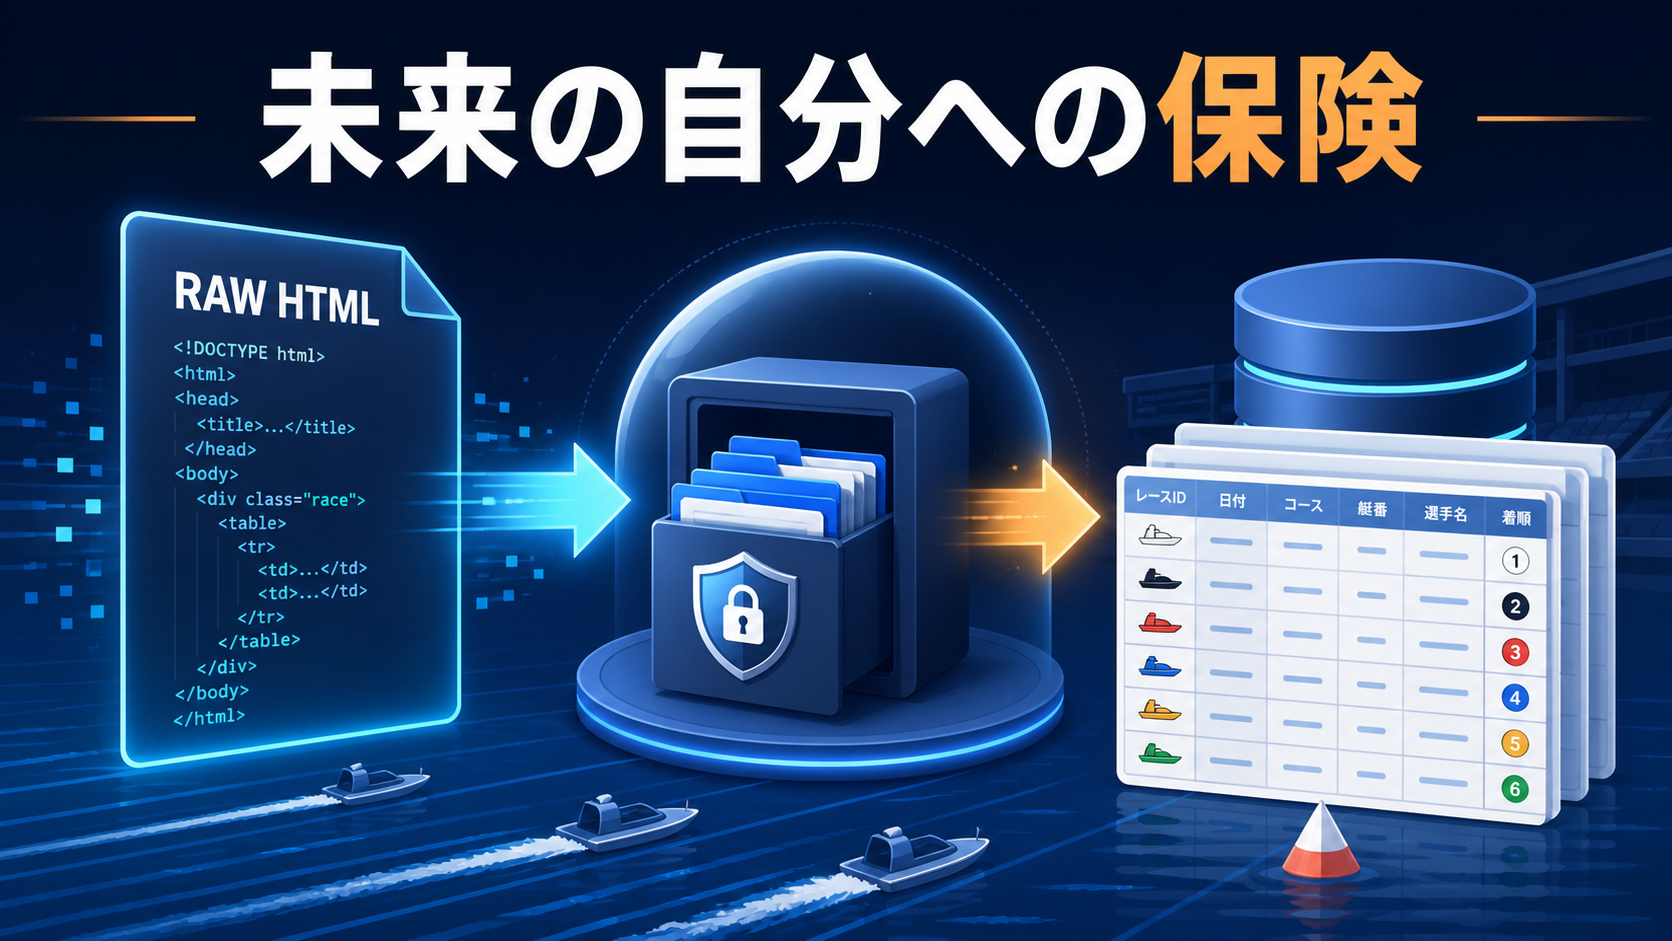
Raw HTMLは、未来の自分へ残す「やり直しの保険」である。
今すぐ中身を理解できなくても構わない。元データさえ残っていれば、データベースも分析方法も、あとから何度でも作り直せる。
📱 スマホで読めます 💻 PC推奨
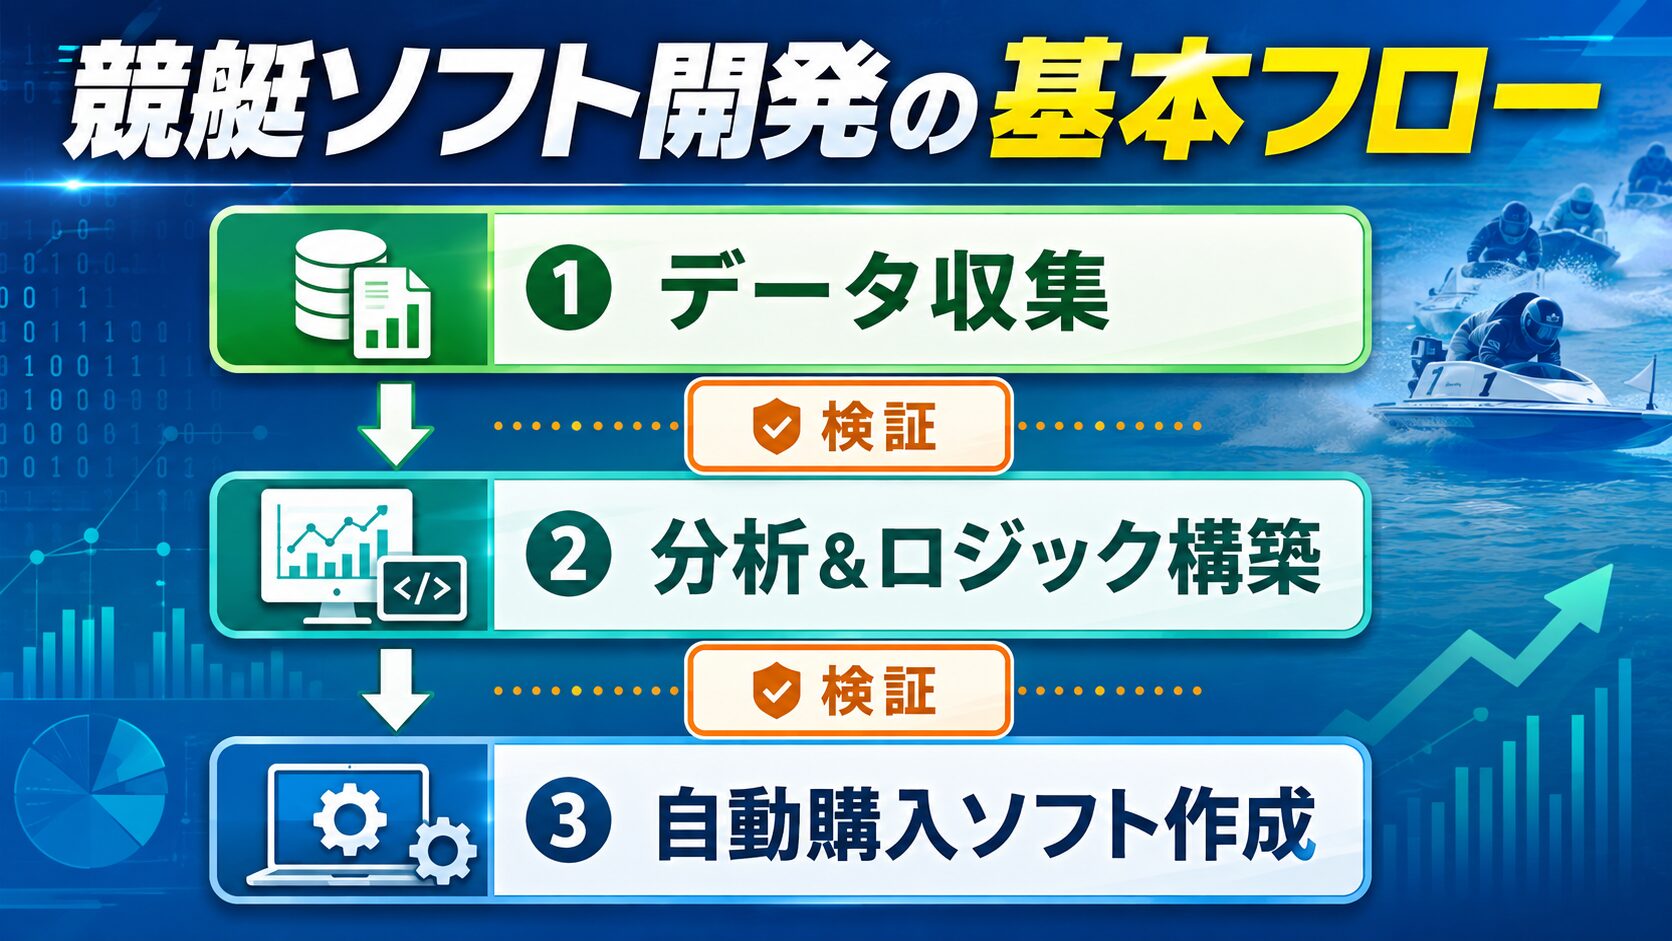
競艇ソフトを作り始めると、出走表・直前情報・結果・オッズを、できるだけ早くExcelやデータベースへ整理したくなる。
きれいな表が完成すると、データを集めた実感も得られる。しかし、完成した表だけを残して元のHTMLを捨ててしまうと、数か月後、数年後の修正が難しくなる。
私自身、データベースを作り続ける中で何度も仕様を変更してきた。その経験から、先に結論を述べる。
データはRaw HTMLから展開する。
加工前の元データを残し、必要な形へ何度でも作り直せるようにする。
Raw HTMLとは何か
Rawとは「加工していない、生の状態」という意味である。ここでいうRaw HTMLは、競艇オフィシャルサイトのページを構成しているHTMLを、加工前のまま保存したファイルを指す。
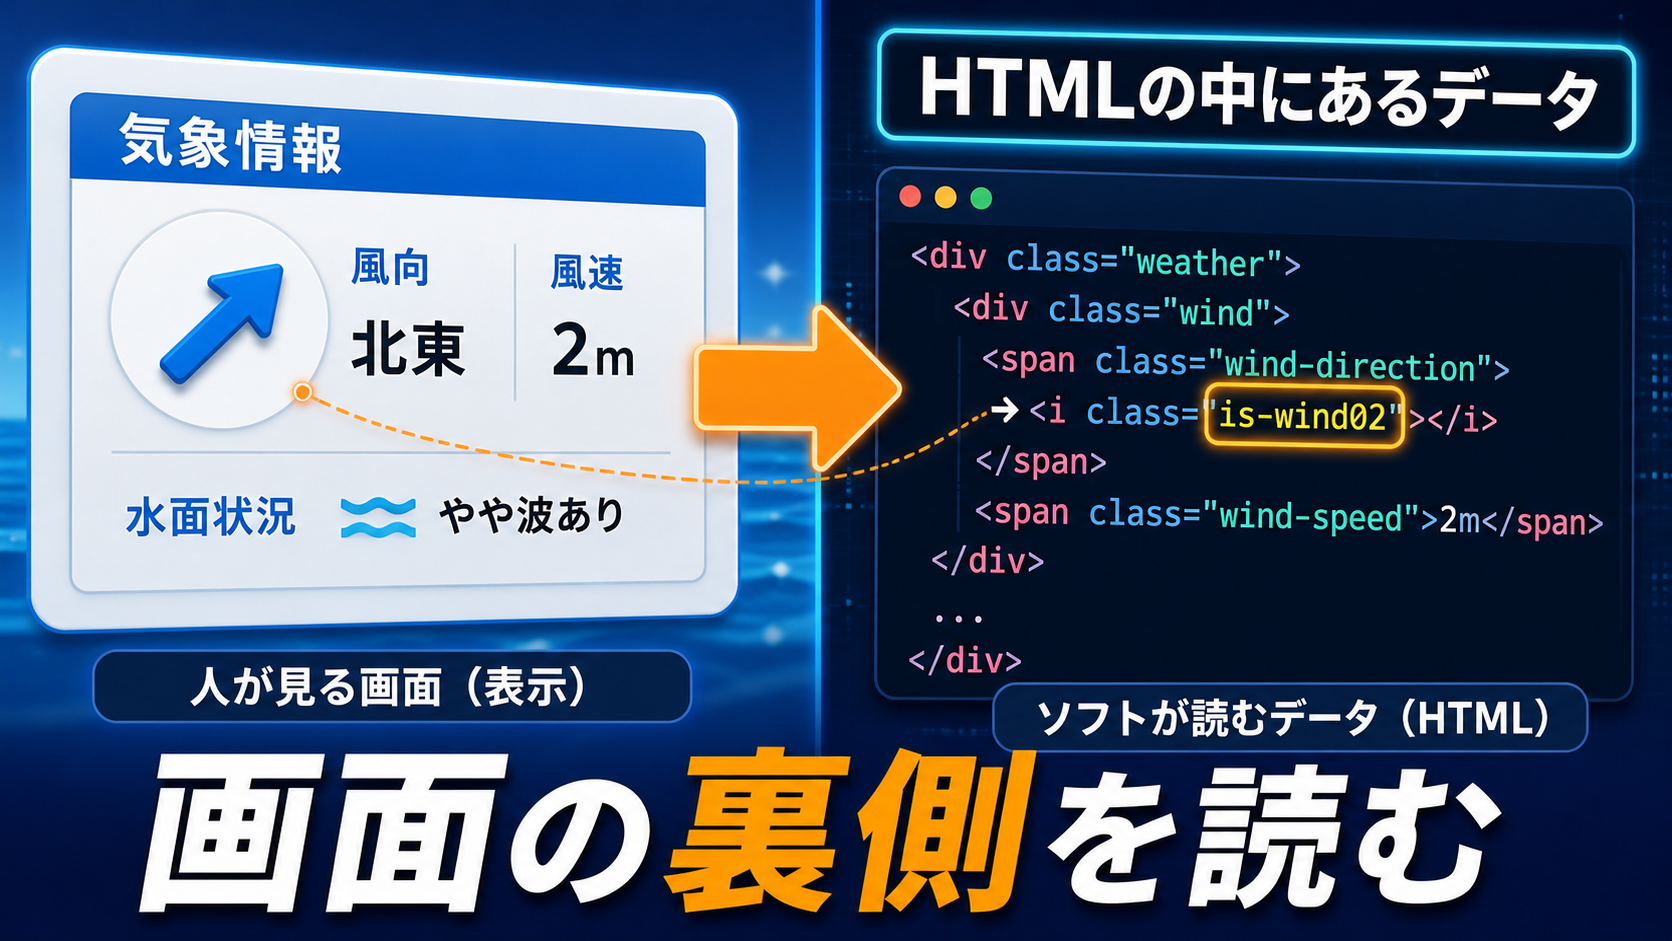
HTMLをメモ帳などで開くと、英字や記号が大量に並んでいる。人間が普段見るWeb画面とは、まったく違うものに見えるかもしれない。
しかし、その中には画面に表示されている選手情報、展示タイム、気象情報、進入、結果などの元になる情報が含まれている。
見た目は読みにくくても、競艇ソフトにとっては貴重な原石である。
なぜ加工済みデータだけでは足りないのか
最初に作ったデータベースが、そのまま最後まで完成形であり続けることはほとんどない。
- あとから必要な項目が増える
- 保存形式を変更したくなる
- 一部の条件だけ取得ミスが見つかる
- 別のロジック用にデータを作り直したくなる
- ExcelからDuckDBやParquetへ移行したくなる
加工済みのExcelファイルしか残っていなければ、そこに存在しない項目は復元できない。取得ミスが加工時に起きたのか、元ページに存在しなかったのかも判断しにくい。
Raw HTMLが残っていれば、元のページを再び読み取り、別のルールでデータを展開できる。オフィシャルサイトへ何万回もアクセスし直す必要もない。
Raw HTMLがあると、何をやり直せるのか
取り出す項目を増やせる
最初は使わなかった情報でも、ロジックの発展によって必要になることがある。元データに含まれていれば、あとから追加できる。
保存形式を変更できる
Excel、CSV、データベース、Parquetなど、保存先や形式はあとから変えられる。Raw HTMLを基準にすれば、新旧データの整合性も確認しやすい。
取得ミスを調査できる
数字がおかしいとき、保存したHTMLまで戻れば原因を切り分けられる。サイト上の表示、HTMLの内容、読み取り処理、保存処理を順番に確認できる。
別のロジックへ再利用できる
現在の予想方法で使わない項目でも、将来の検証で役立つ可能性がある。Raw HTMLは、一つのロジック専用ではない。
HTMLを全部理解する必要はない
HTMLファイルを初めて開くと、「これを全部読めなければ競艇ソフトは作れないのか」と不安になるかもしれない。
その必要はない。目的はHTMLの専門家になることではなく、必要なデータを正しく取り出すことである。
現在は、HTMLの構造確認や読み取りコードの作成をAIに手伝ってもらえる。人間がすべてのタグや記号を暗記する必要はない。
AIに任せること、人間が決めること
AIに手伝ってもらえること
- HTML構造の説明
- 必要な項目の位置探し
- 読み取りコードの作成と修正
- 例外ページや取得ミスの調査
人間が決めること
- 何のためにデータを集めるのか
- どの情報を残すのか
- どのレースを同一データとして結びつけるのか
- 何をもって正しいデータと判断するのか
AIはHTMLを読む作業を助けてくれる。しかし、データの目的と検証基準は人間が決めなければならない。
保存前に決めておきたい最低限のルール
HTMLを保存するだけでも価値はある。ただし、あとから迷子にならないよう、最低限のルールを先に決めておく。
- レースID:日付・会場・レース番号から一つのレースを特定する
- データ種別:出走表・直前情報・結果・オッズを区別する
- ファイル名:同じ規則で保存し、名前だけで内容を判断できるようにする
- 保存場所:年・会場・種類など、自分が探しやすい単位で分ける
- バックアップ:PC故障や誤操作で一度に失わない構成にする
大切なのは、私と同じフォルダ構成を使うことではない。数年後の自分が見ても、どのレースの何のデータかを判断できることである。
最初から大量に集めなくてよい
8年分、約50万レースをいきなり集める必要はない。まずは1日、1会場、数レースで確認する。
- HTMLを保存できるか
- ファイル名からレースを特定できるか
- 必要なデータを取り出せるか
- 元のHTMLと加工後の数字が一致するか
小さな範囲で「保存できる・取り出せる・検証できる」を確認してから広げる方が、安全で速い。
データベースは作り直せる。分析ロジックも改善できる。
しかし、元になるRaw HTMLがなければ、やり直すたびに再取得から始めなければならない。だから、HTML保存は未来の自分への保険なのである。
コメント